
 摘要:
语音识别原理:从声音到文字的转换语音识别原理语音识别是一种将人类语音转换为可计算机理解的数字信号的技术。这种技术早在上世纪50年代就已经开始研究,但由于受限于当时计算机...
语音识别原理:从声音到文字的转换
语音识别原理
语音识别是一种将人类语音转换为可计算机理解的数字信号的技术。这种技术早在上世纪50年代就已经开始研究,但由于受限于当时计算机技术的水平,一直无法实现较高水平的准确度。随着计算机技术的不断进步,语音识别技术也得到了迅速发展。本文将重点介绍语音识别的原理及其实现方式。

声音的基本特征是什么?
声音是由一系列能传播的机械波构成的。机械波可以看作是空气分子在水平方向上的来回振动。声波传播时,每个分子都会向它旁边的分子传递机械能。从物理学的角度来看,声波可以用振幅、频率、相位等参数来描述。在语音识别中,我们主要关注声波的频率、幅度、时间和谐波等方面。
语音信号与其他信号的不同之处在哪里?
与其他信号相比,语音信号具有一定的规律性和特征性。语音信号是由一系列的语音单元组成的,例如音素、音节、词等。这些单元之间存在着明显的时序关系。语音信号的频率范围和动态范围都非常广泛,通常为20Hz~20kHz和60dB~80dB。这使得语音信号在处理过程中需要考虑其动态范围的调整和对其频率特征的提取。
如何对声音信号进行预处理?
在语音识别过程中,声音信号的预处理是非常重要的一步。其目的是将原始声音信号转化为计算机可以处理的数字信号,以方便后续处理。预处理过程一般包括几个步骤:去噪、滤波、分帧、端点检测和归一化等。去噪是为了去除环境噪声;滤波是为了去除非语音部分;分帧是将连续的语音信号分为若干短时段;端点检测是为了确定语音片段的开始和结束位置;归一化是为了统一不同语音的幅度。

如何提取声音的频率特征?
语音信号中的频率特征可以用声谱图来表示。声谱图可以通过对语音信号进行傅里叶变换得到。傅里叶变换是一种将时域信号转换为频域信号的方法,它可以将语音信号在频域上进行分解,并得到各个频率分量的幅度和相位信息。声谱图的横轴表示时间,纵轴表示频率,颜色表示强度。通过观察声谱图中的频率特征,可以确定语音单元的边界。
如何进行语音单元识别?
语音单元识别是语音识别中最重要的一步。其目的是将语音信号分解为一个一个的语音单元,例如音素、音节、词等。传统的语音识别系统主要采用基于模板匹配的方法进行单元识别。该方法基于预先录制好的模板库,将语音信号与模板进行比较,找到最相似的单元。但是该方法存在模板库容量限制和模板匹配的局限性等问题。目前较为流行的是基于深度学习的方法,例如卷积神经网络和循环神经网络等。
如何进行特征提取?
特征提取是指从语音信号中提取有用的信息来描述其特征。在语音识别中,常用的特征包括梅尔频率倒谱系数(MFCC)、线性预测系数(LPC)、自相关函数(ACF)等。MFCC是目前应用最广泛的一种特征,它将声谱图映射到一个较低维度的特征空间中,以便于后续处理。LPC是一种基于自回归模型的特征,其主要思想是将语音信号看作是由一个滤波器所产生的输出,通过对该滤波器参数进行估计,来描述语音信号的特征。
如何进行语音识别?
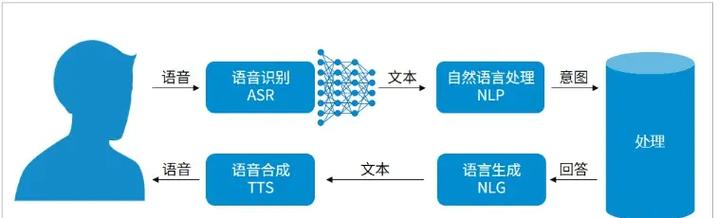
语音识别是一个复杂的过程,其核心是建立一个模型来对语音信号进行建模和识别。常用的模型包括隐马尔可夫模型(HMM)、深度神经网络(DNN)、循环神经网络(RNN)等。HMM是一种基于状态转移的模型,它将语音信号分解为若干状态序列,并利用马尔可夫过程来描述状态之间的转移。DNN和RNN是深度学习领域的两种典型模型,其优势在于可以从大量的语音数据中进行自动学习,并且具有较高的准确度。
语音识别中的模型训练过程是什么?
模型训练过程主要包括数据预处理、模型选择、参数优化等步骤。需要对语音数据进行预处理和清洗,以提高数据质量。然后选择合适的模型结构和训练算法,并对模型进行参数初始化。接着,采用反向传播算法对模型进行训练,通过不断调整参数,使得模型的预测结果逼近真实标签。对训练好的模型进行评估和测试,以验证其准确性和鲁棒性。
如何提高语音识别的准确率?
提高语音识别准确率的方法包括增加训练数据量、改进特征提取算法、优化模型结构等。增加数据量是提高准确率的最直接方式,但是收集和标注大量的数据也是一项非常困难和耗时的工作。改进特征提取算法可以从声学特征层面上提高语音识别准确度。优化模型结构则可以从更深层次上提高语音识别的准确度,例如采用深度神经网络和循环神经网络等模型。
语音识别技术的应用领域有哪些?
语音识别技术的应用领域非常广泛,包括语音翻译、语音助手、智能家居等。语音翻译技术可以将一种语言翻译成另一种语言,帮助人们进行跨文化交流。语音助手可以为用户提供各种服务,例如播放音乐、查询天气等。智能家居可以实现远程控制和自动化管理,使生活更加便捷和舒适。
语音识别技术的发展趋势是什么?
语音识别技术的发展趋势是向更智能化和更人性化方向发展。随着人工智能技术的不断发展和应用,语音识别技术将会变得更加智能化和自适应。未来的语音识别技术不仅可以识别人类语音,还可以识别各种环境噪声、声纹、情感等信息,从而更好地满足人们的需求。
语音识别技术的局限性是什么?
语音识别技术的局限性主要包括语音质量、噪声干扰、口音差异、话语间连贯性等方面。语音识别技术对语音质量的要求较高,只有高质量的语音才能得到准确的识别结果。噪声干扰是语音识别中常见的问题,特别是在复杂的环境下,如风吹雨打等。再次,不同地区和文化背景的人可能存在口音差异,这也会影响到语音识别的准确率。话语之间的连贯性也是一个重要因素,例如话语中断或者说话人发生变化等都会对识别结果产生影响。
语音识别技术与隐私保护的关系如何?
随着语音识别技术的广泛应用,隐私保护问题也越来越引人注目。一方面,语音识别技术需要收集大量的个人语音数据用于训练和测试,这可能涉及到用户隐私的泄露。另一方面,识别过程中可能会涉及到敏感信息的获取和使用,例如用户的姓名、地址、电话等。在应用语音识别技术时,需要制定合理的隐私保护措施,并尽可能减少敏感信息的获取和存储。
语音识别技术的未来发展前景如何?
语音识别技术的未来发展前景非常广阔,其应用领域和影响范围也将越来越广泛。随着语音识别技术的发展,未来可能会涌现出更多的语音交互方式和产品,如智能音箱、自动驾驶汽车等。语音识别技术还可以与其他人工智能技术相结合,例如自然语言处理、机器学习等,从而更好地实现人机交互和智能服务。
语音识别技术是一种将人类语音转换为可计算机理解的数字信号的技术。它的核心是建立一个模型来对语音信号进行建模和识别。在实际应用中,需要进行声音信号的预处理、特征提取、模型训练和语音单元识别等步骤。语音识别技术的发展趋势是向更智能化和更人性化方向发展。虽然存在一些局限性和隐私保护问题,但是随着人工智能技术的不断发展,语音识别技术的应用前景非常广阔。